Prompt injection é o ataque em que um texto lido pelo modelo passa a valer como ordem. O agente recebe um e-mail, uma issue de repositório, uma página web ou uma linha de banco de dados, encontra ali uma instrução escrita por outra pessoa e a executa como se ela tivesse vindo de quem opera o sistema. Nada quebra, nenhum log de erro aparece, e a ferramenta conectada faz exatamente o que o texto mandou.
A causa está numa decisão de arquitetura dos LLMs: instrução e dado viajam no mesmo canal. O modelo lê uma sequência de tokens sem um campo que diga "isto é comando" e outro que diga "isto é conteúdo a processar". Enquanto o sistema só gerava texto, o estrago parava na resposta. Depois que ele ganhou ferramentas e credenciais, cada trecho de conteúdo não confiável virou uma chamada de API em potencial.
A OWASP manteve prompt injection na primeira posição do Top 10 para aplicações de LLM na edição de 2026, publicada em agosto e construída sobre 7.714 incidentes reais catalogados. Em dezembro de 2025, o mesmo projeto lançou um Top 10 dedicado a aplicações agênticas, com categorias próprias para sequestro de objetivo, uso indevido de ferramenta e abuso de identidade. Este guia trata da defesa desse cenário: o agente que já está em produção, com acesso a dado e a ferramenta.
Por que um agente com ferramentas transforma texto em ação
Um chatbot que só responde tem superfície de ataque pequena: no limite, quem injeta instrução nele obtém uma resposta fora de política ou o vazamento do prompt de sistema. O risco muda de natureza quando o mesmo modelo ganha um cliente de e-mail, um repositório, um banco transacional ou um servidor de ferramentas.
Simon Willison, que cunhou o termo prompt injection em 2022, descreve a combinação perigosa como trifeta letal: acesso a dado privado, exposição a conteúdo não confiável e um canal de saída para o mundo externo. Com os três presentes, um único conteúdo envenenado encadeia leitura, decisão e exfiltração sem tocar em nenhuma vulnerabilidade de código tradicional. O canal de saída é o elemento subestimado, porque ele raramente aparece com esse nome na arquitetura: ele se apresenta como renderização de imagem em Markdown, encurtador de URL, webhook de notificação ou commit em branch pública. Qualquer primitiva que carregue bytes para um endereço de terceiro serve de saída.
Injeção direta e injeção indireta: quem escreve a instrução
Na injeção direta, quem ataca é quem conversa com o agente. O objetivo típico é contornar política, extrair o prompt de sistema ou obter uma ação que aquela sessão não deveria conseguir. O vetor é visível e fica registrado no histórico.
Na injeção indireta, a instrução chega escondida em conteúdo que o agente busca para cumprir uma tarefa legítima. Ninguém precisa de acesso ao sistema: basta escrever em algo que o agente vai ler depois, como um ticket de suporte, um README ou um PDF anexado. Por isso o controle muda de lugar. Injeção direta se combate na fronteira da conversa; injeção indireta exige tratar todo conteúdo recuperado como dado hostil por padrão, porque ele entra depois da autenticação, carregando a permissão de quem pediu a tarefa.
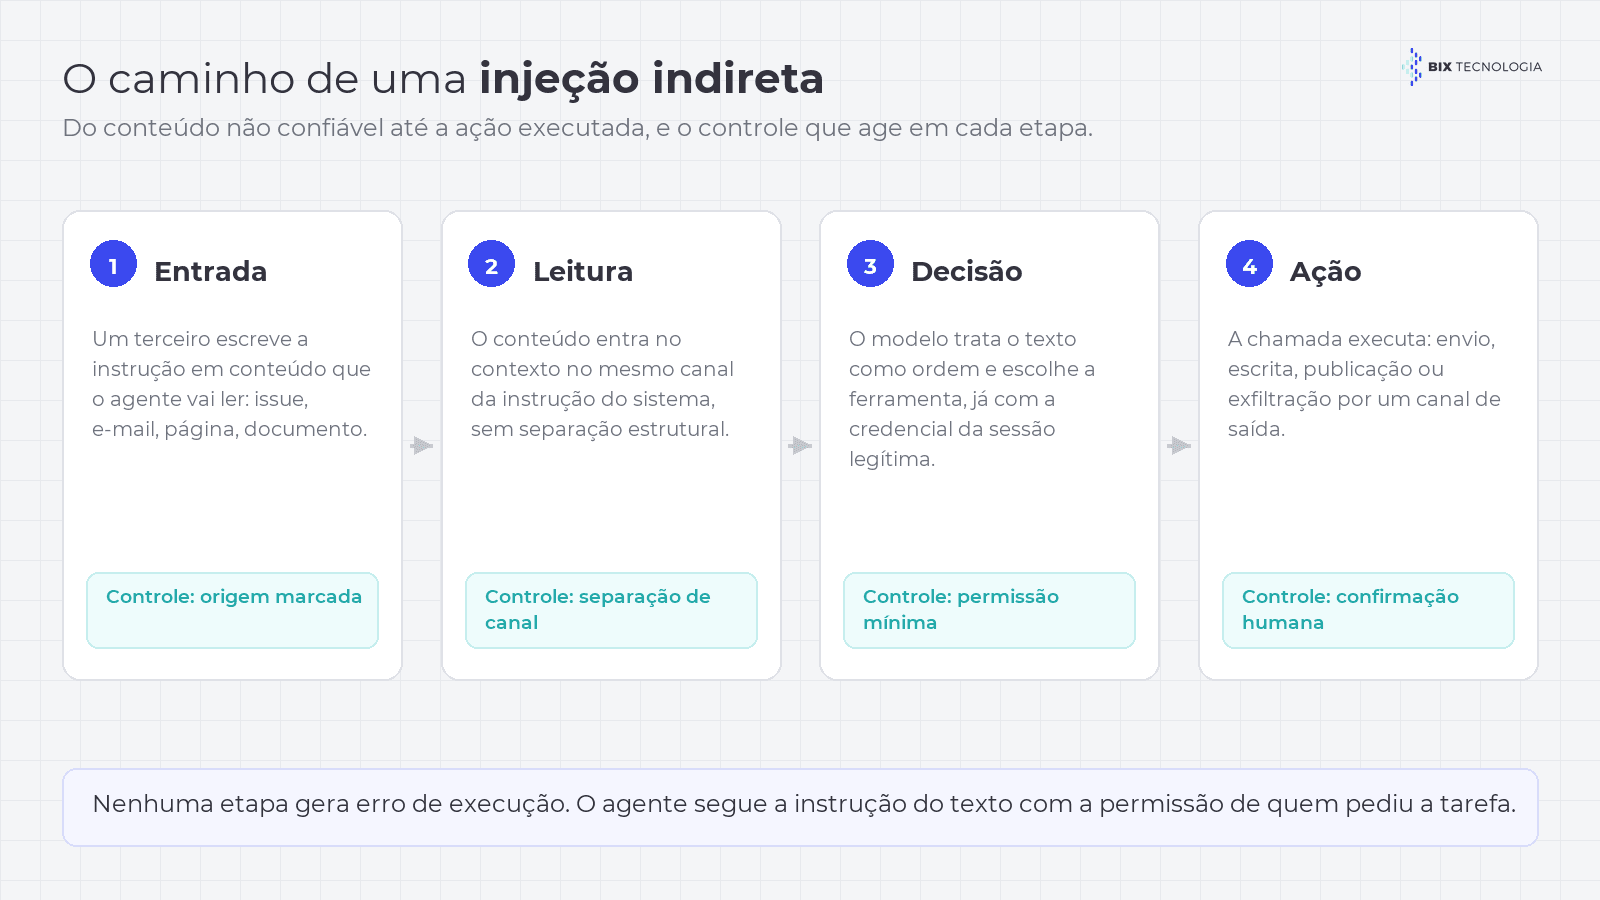
O texto não confiável percorre quatro etapas até virar ação. Cada uma delas admite um controle diferente.
Uma nota de pesquisa da Cloud Security Alliance publicada em abril de 2026 mediu a operacionalização desse vetor. O Google registrou aumento relativo de 32% em conteúdo malicioso de injeção entre novembro de 2025 e fevereiro de 2026, a Unit 42 mapeou vinte e duas técnicas de entrega em uso ativo, e 85,2% dos casos analisados combinavam ocultação com engenharia social. O método de ocultação mais comum era texto legível com tamanho de fonte zero, em 37,8% dos casos.
| Critério | Injeção direta | Injeção indireta |
|---|---|---|
| Quem escreve a instrução | o usuário da sessão | terceiro, em conteúdo que o agente lê |
| Onde entra | prompt do usuário | e-mail, issue, página, documento, resposta de ferramenta |
| Acesso necessário | acesso ao agente | nenhum, basta escrever no conteúdo |
| Objetivo típico | burlar política, extrair prompt de sistema | exfiltrar dado, executar ação privilegiada |
| Sinal de detecção | tentativa visível no histórico | divergência entre o plano e a chamada executada |
O ecossistema de agentes de código mostrou o tamanho do problema neste ano. A mesma organização documentou o incidente batizado de Clinejection, explorado em 17 de fevereiro, em que uma issue forjada levou o fluxo automático de triagem de um repositório a publicar um pacote npm comprometido, disponível por cerca de oito horas. No mesmo ciclo, uma falha de validação de comando no Claude Code, registrada como CVE-2025-66032 e corrigida na versão 1.0.93, permitia contornar o mecanismo de comandos somente leitura, e explorá-la dependia de inserir conteúdo não confiável no contexto do agente.
As defesas contra prompt injection que funcionam em camada
Nenhum filtro resolve prompt injection sozinho. Um estudo empírico sobre evasão de guardrails, apresentado no LLMSec 2025, testou seis sistemas de detecção, entre eles o Azure Prompt Shield e o Prompt Guard da Meta, e obteve até 100% de evasão em alguns cenários mantendo a utilidade do ataque. O detector continua valendo como primeira barreira barata, desde que o desenho não dependa dele.
A orientação de arquitetura convergiu para defesa em profundidade. A documentação de segurança da Microsoft para ataques de injeção indireta parte de uma premissa explícita: projete assumindo que alguma injeção vai passar, e combine controle probabilístico com controle determinístico. Quatro camadas sustentam esse desenho.
Separação de canal de instrução e de dado
A primeira camada ataca a causa. Todo conteúdo recuperado entra no contexto marcado como dado, com delimitador estável, e o prompt de sistema instrui o modelo a nunca executar instrução vinda dali. A técnica é conhecida como spotlighting, e reduz a taxa de sucesso sem eliminá-la.
O ganho real vem da separação estrutural. O artigo "Design Patterns for Securing LLM Agents against Prompt Injections", de 2025, descreve seis padrões que restringem o que o agente pode fazer, em vez de adivinhar a intenção do texto. No padrão dual LLM, um planejador privilegiado nunca lê o conteúdo não confiável, e um trabalhador em quarentena lê o conteúdo sem ter ferramenta alguma. No padrão plan-then-execute, o agente fixa a sequência de chamadas antes de tocar no dado externo, e o texto lido não consegue acrescentar chamada fora do plano. O custo é flexibilidade: quanto mais rígido o padrão, menor o conjunto de tarefas que o agente resolve sozinho.
Permissão mínima por ferramenta
A segunda camada limita o estrago. Cada ferramenta exposta ao agente recebe escopo próprio, credencial de vida curta e limite de volume, em vez de herdar o token completo do usuário. Um agente que só precisa ler pedidos não recebe permissão de escrita no banco, e um que resume repositório não recebe permissão de publicar pacote.
Desenhe a permissão junto com a integração. Quem usa MCP para conectar agentes a ferramentas externas tem no manifesto de cada servidor o inventário das ações disponíveis, e é ali que a lista deve ser revisada. Vale também quebrar a trifeta de propósito: um agente que lê conteúdo público e acessa dado privado não deveria ter, na mesma sessão, uma ferramenta capaz de mandar bytes para fora.
Confirmação humana em ação irreversível
A terceira camada aceita que algo passou. Toda ação sem volta pede aprovação explícita de uma pessoa: transferência financeira, exclusão de recurso, envio de mensagem para fora da organização, publicação de artefato, alteração de permissão. O gatilho é a reversibilidade da ação, e não a confiança no modelo.
A armadilha é a fadiga de aprovação: uma confirmação a cada passo treina o operador a clicar sem ler, o que anula a camada. Classifique as ferramentas por impacto, deixe as reversíveis passarem direto e reserve a interrupção para o conjunto pequeno de operações críticas, sempre mostrando o argumento exato da chamada.
Registro de auditoria que reconstrói a decisão
A quarta camada é o que permite responder depois do incidente. O rastro guarda o que entrou no contexto, qual conteúdo foi recuperado e de onde, qual plano o modelo formulou, quais ferramentas foram chamadas com quais argumentos e quem aprovou o quê. Sem a origem do conteúdo, ninguém aponta qual documento carregava a instrução.
Esse registro é o mesmo ativo que sustenta a observabilidade de agentes com OpenTelemetry e a supervisão de agentes em tempo real. A detecção mais confiável em produção é a divergência entre plano e execução: o agente declarou três chamadas, executou cinco, e as duas extras apareceram depois de um documento externo entrar no contexto.
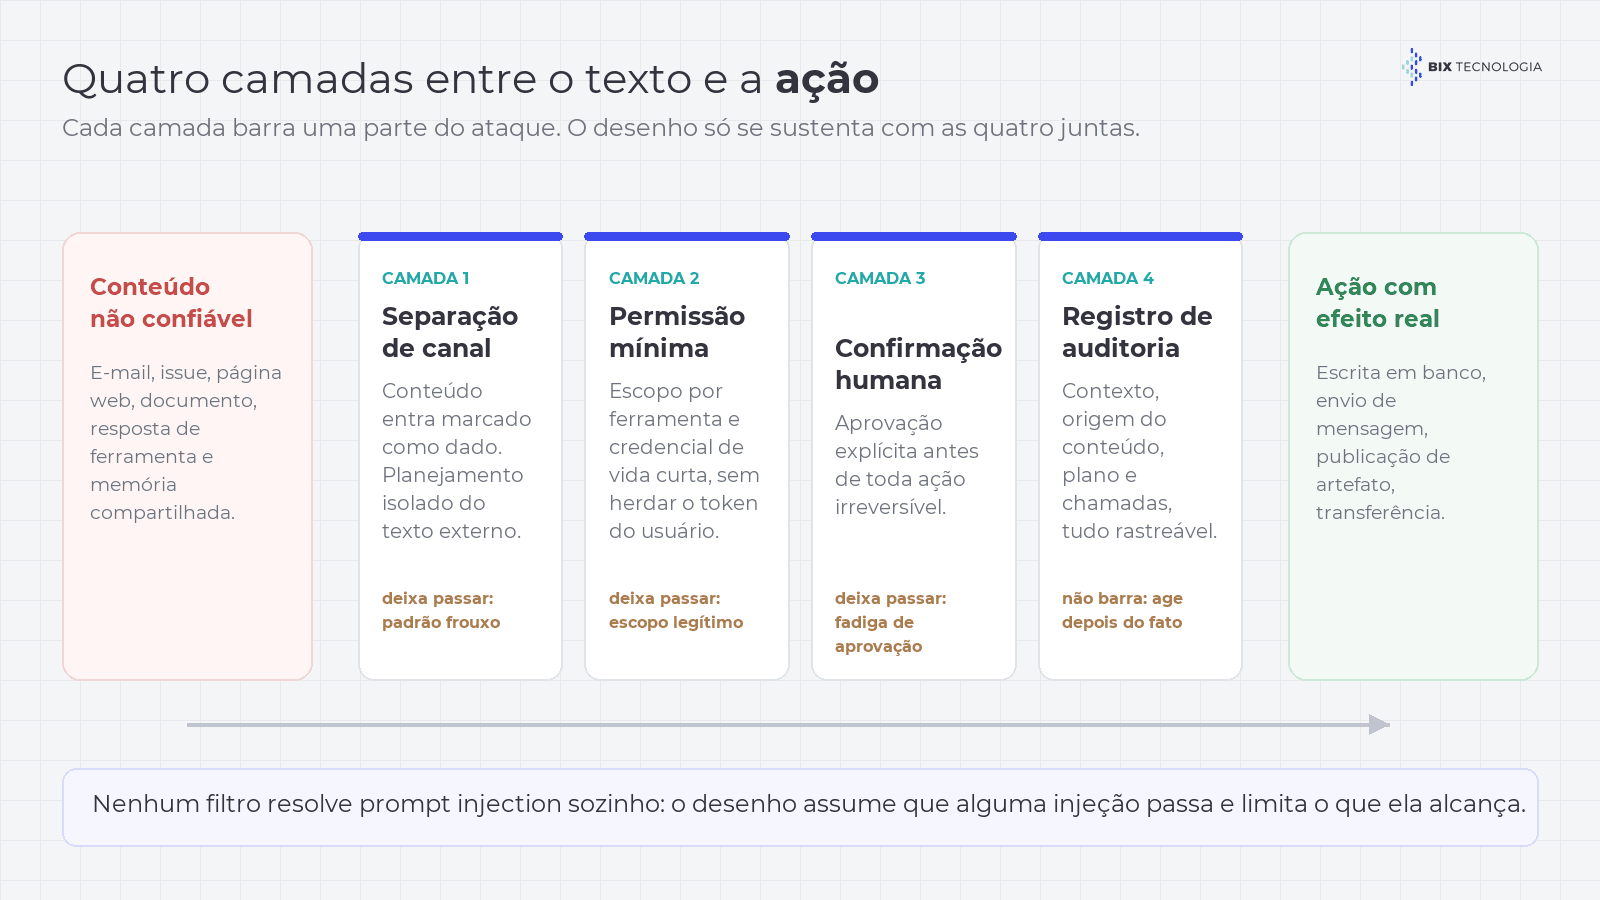
Cada camada barra uma parte do ataque e deixa passar outra. O desenho só se sustenta com as quatro juntas.
| Camada | O que ela barra | Onde ela falha | Custo de operação |
|---|---|---|---|
| Filtro de detecção | payload conhecido e ataque genérico | reformulação adaptativa, idioma raro, codificação | baixo, com falso positivo |
| Separação de canal | instrução que depende de ser lida como ordem | padrão frouxo, sem isolar o planejamento | médio, reduz autonomia |
| Permissão mínima | conversão do acesso em ação danosa | ferramenta legítima usada dentro do escopo | médio, exige inventário |
| Confirmação humana | ação irreversível disparada por injeção | fadiga de aprovação, argumento não exibido | alto, atrito no fluxo |
| Auditoria | nada, em tempo de execução | rastro sem origem do conteúdo recuperado | baixo, custo de armazenamento |
O que testar antes de subir o agente para produção
Teste de agente sob ataque virou etapa de release. O AgentDojo, referência pública mais usada hoje, organiza 97 tarefas de usuário e 629 casos de segurança em domínios como banco e workspace, e mede três números que andam juntos: a utilidade em condição normal, a utilidade sob ataque e a taxa de sucesso do ataque. Olhar só para o terceiro produz o agente seguro e inútil, aquele que recusa tarefa legítima. Um teste interno mínimo cabe em uma rodada: monte casos de injeção indireta nos canais que o seu agente lê, com pelo menos três formas de ocultação, e verifique se cada tentativa aparece no rastro com a origem certa. Repita a bateria a cada troca de modelo, porque a resposta a payloads muda entre versões.
A conformidade entra junto com o teste. No Brasil, o PL 2338/2023 foi aprovado no Senado em dezembro de 2024 e aguarda votação na Câmara, e a ANPD colocou inteligência artificial e tecnologias emergentes entre os eixos prioritários de fiscalização do biênio 2026 e 2027. Um agente que executa ação sobre dado pessoal sem rastro de decisão fica exposto nas duas frentes, e é por isso que o registro de auditoria costuma ser a primeira camada cobrada em auditoria externa.
Prompt injection não tem correção definitiva à vista, porque a causa está no formato com que o modelo recebe o mundo. O que existe é engenharia: reduzir o que o agente alcança, separar o canal por onde o conteúdo entra, interromper a execução antes do ato sem volta e guardar rastro para reconstruir a decisão. Times que tratam essa combinação como requisito de arquitetura colocam agente em produção com risco medido. Comece listando as ferramentas do seu agente e marcando quais conseguem mandar dado para fora, porque essa coluna costuma ser mais longa do que o time imagina, e ela é a base de qualquer política de governança de LLMs.
Se a sua empresa tem agentes de IA em produção lendo conteúdo de fora e executando ação com credencial de usuário, nossos especialistas podem ajudar a desenhar as camadas de isolamento, permissão e auditoria adequadas ao seu contexto. Fale com a nossa equipe e avance na maturidade dos seus dados.

Perguntas frequentes sobre prompt injection
O que é prompt injection? Prompt injection é o ataque em que um texto processado por um modelo de linguagem passa a ser executado como instrução. Acontece porque instrução e dado chegam ao modelo no mesmo canal de tokens, sem separação estrutural. Em agentes com ferramentas conectadas, a instrução injetada vira chamada de API com a credencial da sessão legítima.
Qual a diferença entre prompt injection direto e indireto? No ataque direto, quem escreve a instrução maliciosa é o próprio usuário da sessão, em geral para burlar política ou extrair o prompt de sistema. No indireto, a instrução vem escondida em conteúdo que o agente lê para cumprir a tarefa, como e-mail, issue, página web ou documento, e não exige nenhum acesso ao sistema.
Como proteger agentes de IA contra prompt injection? Combine quatro camadas: separação entre canal de instrução e canal de dado, permissão mínima e credencial de vida curta por ferramenta, confirmação humana em toda ação irreversível e registro de auditoria que guarde a origem do conteúdo recuperado. A documentação de segurança da Microsoft recomenda projetar assumindo que alguma injeção vai passar.
Filtro de prompt injection resolve o problema? Sozinho, não resolve. Um estudo empírico apresentado no LLMSec 2025 testou seis sistemas de detecção, entre eles o Azure Prompt Shield e o Prompt Guard da Meta, e alcançou até 100% de evasão em alguns cenários preservando a utilidade do ataque. O filtro serve como primeira barreira, com o desenho de segurança apoiado nas camadas seguintes.
O que é a trifeta letal em agentes de IA? É a combinação de acesso a dado privado, exposição a conteúdo não confiável e um canal de comunicação com o exterior, descrita por Simon Willison em 2025. Quando os três estão presentes na mesma sessão, uma injeção consegue ler, decidir e exfiltrar. Remover um dos três elementos interrompe a cadeia do ataque.