Change data capture com Debezium: do log ao lakehouse
Change data capture é a técnica que captura cada inserção, atualização e exclusão de um banco transacional lendo o log de transações que ele já escreve para garantir durabilidade e replicação. O banco não recebe nenhuma consulta extra, a captura enxerga todas as operações na ordem em que foram confirmadas, e o consumidor recebe o evento poucos instantes depois do commit.
A alternativa que a maior parte dos times ainda usa é a carga incremental por coluna de data: de hora em hora, um job pergunta quais linhas têm updated_at maior que a última execução e reprocessa esse recorte. Funciona, e cobra caro em três frentes. O DELETE some do radar, porque a linha apagada não aparece em nenhuma consulta. Os estados intermediários se perdem, já que uma linha atualizada três vezes na mesma hora chega ao destino uma vez só. A varredura periódica ainda compete com a carga transacional nas tabelas mais movimentadas.
Este guia mostra como o Debezium lê esse log, o que ele publica em cada evento e quais são os caminhos até uma tabela Iceberg ou Delta com upserts aplicados. O destino é o mesmo em qualquer arquitetura de lakehouse: uma tabela analítica que reflete o estado atual do sistema de origem, com histórico preservado quando o negócio precisa dele.
Como o change data capture lê o log de transações do banco
Todo banco relacional escreve as mudanças em um log antes de aplicá-las aos arquivos de dados. No PostgreSQL esse log é o WAL (write-ahead log), no MySQL é o binlog, no Oracle são os redo logs, lidos via LogMiner, e no SQL Server são as tabelas de captura do CDC nativo. Esse log existe para recuperação de falha e para replicação, portanto a informação já está lá, completa e ordenada, antes de qualquer ferramenta de integração entrar em cena.
O CDC por log se conecta como mais um consumidor desse fluxo. No PostgreSQL, a configuração mínima é wal_level=logical, um slot de replicação que marca até onde o consumidor já leu e uma publication que define quais tabelas entram na captura. O slot guarda um LSN, o ponteiro persistente de posição no WAL, e o banco só recicla os segmentos que ficaram para trás desse ponteiro. Daí vem a principal consequência operacional: um consumidor parado segura WAL em disco.
A comparação com a carga incremental fica mais clara quando você separa o que cada abordagem consegue enxergar.
| Critério | CDC por log de transações | Carga incremental por coluna de data |
|---|---|---|
Captura DELETE | Sim, com a imagem anterior da linha | Não, a linha apagada some da consulta |
| Estados intermediários | Todos, na ordem de commit | Só o último estado da janela |
| Carga no banco de origem | Leitura do log, sem consulta às tabelas | Varredura periódica das tabelas |
| Latência típica | Segundos após o commit | O intervalo do agendamento |
| Pré-requisitos | Acesso ao log, slot, permissão de replicação | Uma coluna de data confiável em cada tabela |
| Risco silencioso | Slot parado acumula WAL em disco | Linha atualizada sem tocar a coluna de data |
O último item costuma pegar os times de surpresa. Uma coluna updated_at mantida pela aplicação, e não por trigger, deixa de ser preenchida em qualquer caminho de escrita que ninguém instrumentou, inclusive correções manuais em produção. A carga incremental passa então a ignorar aquelas linhas em silêncio, sem erro e sem alerta.
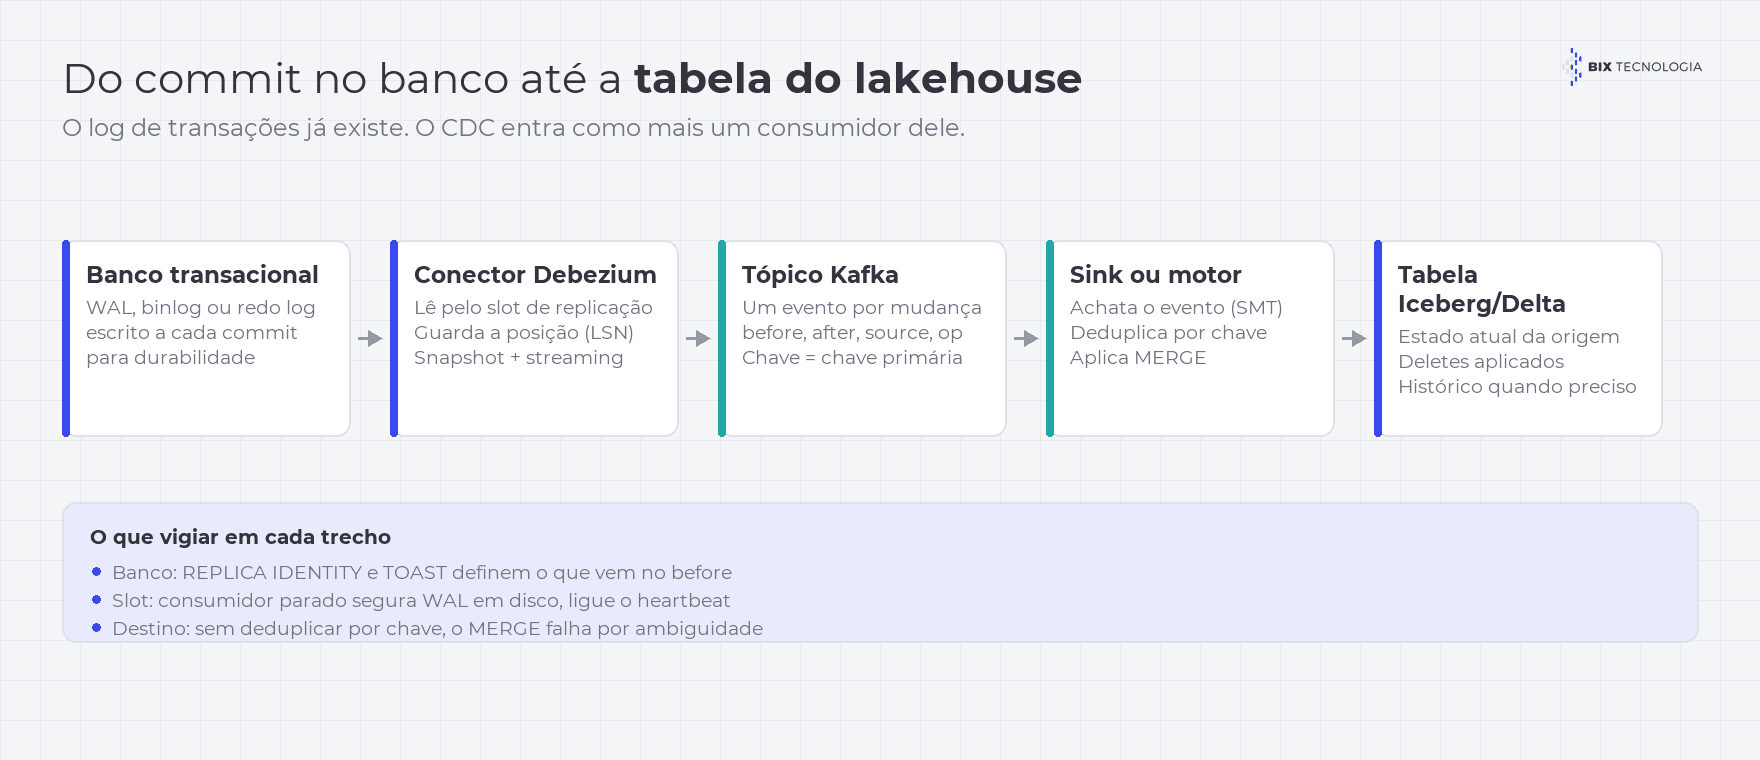
Do commit ao lakehouse: o log de transações é a fonte, o Debezium é o leitor e o sink é quem converte o fluxo de eventos em estado atual da tabela.
O que o Debezium entrega sobre o Kafka
O Debezium é um conjunto de conectores de origem para o Kafka Connect. A série estável atual é a 3.6, cuja última correção, a 3.6.2.Final, saiu em 1º de setembro de 2026. Conforme a documentação do projeto, ela pede Java 17 ou superior, roda sobre Kafka Connect 3.1 ou superior e cobre PostgreSQL 14 a 18, MySQL 8.0 a 9.1, SQL Server 2017 a 2022 e Oracle de 19c a 26ai por LogMiner, além de MongoDB, Db2, MariaDB e Cassandra.
Cada mudança vira um evento de estrutura fixa. A chave do registro carrega a chave primária da linha. O valor traz before com a imagem anterior, after com a imagem nova, source com metadados de origem, como LSN, banco e tabela, e o campo op, que assume c para insert, u para update, d para delete e r para linha lida em snapshot. Um DELETE ainda pode ser seguido de um tombstone, de mesma chave e valor nulo, que permite ao Kafka descartar o histórico daquela chave em tópicos compactados.
Snapshot inicial e snapshot incremental
O histórico que já existia antes do conector subir não está no log. Por isso o Debezium começa por um snapshot, controlado pela propriedade snapshot.mode, que aceita, entre outros valores, initial (padrão), initial_only, no_data, always e when_needed. As linhas do snapshot chegam com op=r e, ao final, o conector emenda no streaming a partir da posição registrada.
Em tabelas grandes, o snapshot inicial trava a esteira por horas. A alternativa é o snapshot incremental, baseado no design DDD-3: o conector ordena a tabela pela chave primária, divide em blocos de 1024 linhas por padrão e captura bloco a bloco em paralelo com o streaming, resolvendo por marcas d'água as colisões entre a linha lida no snapshot e a alteração recém-transmitida. Ele é disparado por sinal, sobrevive a interrupção sem recomeçar do zero e pode ser repetido quando uma tabela nova entra na captura.
O que quebra na prática
Três armadilhas aparecem em quase toda implantação no PostgreSQL. A primeira é o REPLICA IDENTITY: no padrão DEFAULT, o evento de update traz só a chave primária no before, e apenas REPLICA IDENTITY FULL entrega a imagem anterior completa, ao custo de WAL maior. A segunda é o TOAST, mecanismo que guarda valores acima de cerca de 8 KB fora da página: colunas toasted que não mudaram ficam de fora do evento, e o conector coloca no lugar o unavailable.value.placeholder, que um sink desatento grava na tabela como se fosse dado real.
A terceira armadilha é o crescimento do WAL. Quando o banco escreve muito em tabelas fora da captura, o conector fica sem eventos para confirmar, o LSN do slot não avança e o disco enche. O caminho documentado é ligar heartbeat.interval.ms e, em casos extremos, usar heartbeat.action.query. Vale lembrar também que cada conector exige seu próprio slot e sua própria publication: dois conectores compartilhando um slot dividem os eventos entre si, e a perda é silenciosa.
Do tópico Kafka à tabela Iceberg ou Delta com upserts
Um tópico Kafka é um fluxo append-only de eventos, e a tabela analítica precisa refletir o estado atual. Alguém, em algum ponto, aplica cada evento como um MERGE. Antes disso, o padrão é achatar o envelope com a transformação ExtractNewRecordState, que promove o conteúdo de after para o nível raiz. Com delete.tombstone.handling.mode=rewrite, ela mantém os deletes no fluxo marcando __deleted=true, e com add.fields=op,table,lsn preserva os metadados necessários para ordenar os eventos no destino.
A partir daí existem três caminhos, e a escolha depende mais da operação do que da tecnologia de tabela.
| Caminho | Como funciona | Upsert e delete | Quando faz sentido |
|---|---|---|---|
| Sink connector direto para Iceberg | O sink Kafka Connect do Apache Iceberg consome o tópico, com commits coordenados, semântica exactly-once e criação automática de tabela | Depende da transformação de CDC e do motor para aplicar deletes de linha | Replicação sem transformação, com o Kafka já em operação |
| Debezium Server com sink Iceberg | O Debezium roda como aplicação autônoma e escreve direto no Iceberg, sem Kafka e sem Kafka Connect | Modo upsert nativo, com deduplicação por __source_ts_ns e soft delete via __deleted | Poucas origens, equipe pequena, menos peças para operar |
| Motor de processamento | Spark Structured Streaming ou Flink lê o tópico e aplica MERGE INTO na tabela Delta ou Iceberg | Total, com a lógica de merge escrita por você ou pelo framework | Quando o caminho exige transformação, junção ou histórico SCD |
O sink Iceberg do Debezium Server merece um aviso: a documentação oficial o descreve como projeto mantido pela comunidade, em repositório separado, e o modo upsert depende do evento achatado pela ExtractNewRecordState. Sem essa transformação, ele opera apenas em modo append.
No terceiro caminho, quem usa Databricks tem as APIs AUTO CDC, que substituíram as antigas APPLY CHANGES mantendo a mesma sintaxe. Você declara a chave, a cláusula SEQUENCE BY e o tipo de dimensão, e o mecanismo resolve ordenação e eventos fora de sequência, entregando SCD tipo 1 ou tipo 2 sem MERGE escrito à mão. A escolha do formato de destino segue a lógica de sempre, e vale rever o comparativo entre Iceberg, Delta Lake e Hudi antes de fixar a arquitetura.
Ordenação e deduplicação são o detalhe que quebra o merge
Um micro-lote quase sempre traz vários eventos da mesma chave primária, e um MERGE INTO que recebe duas linhas com a mesma chave do lado da origem falha, porque a operação fica ambígua. A regra prática é deduplicar antes do merge, mantendo só o evento mais recente de cada chave, ordenado pelo LSN ou pelo timestamp de origem, nunca pelo horário de chegada. Os deletes entram no mesmo merge como cláusula de remoção, ou como marcação lógica quando o negócio pede histórico.
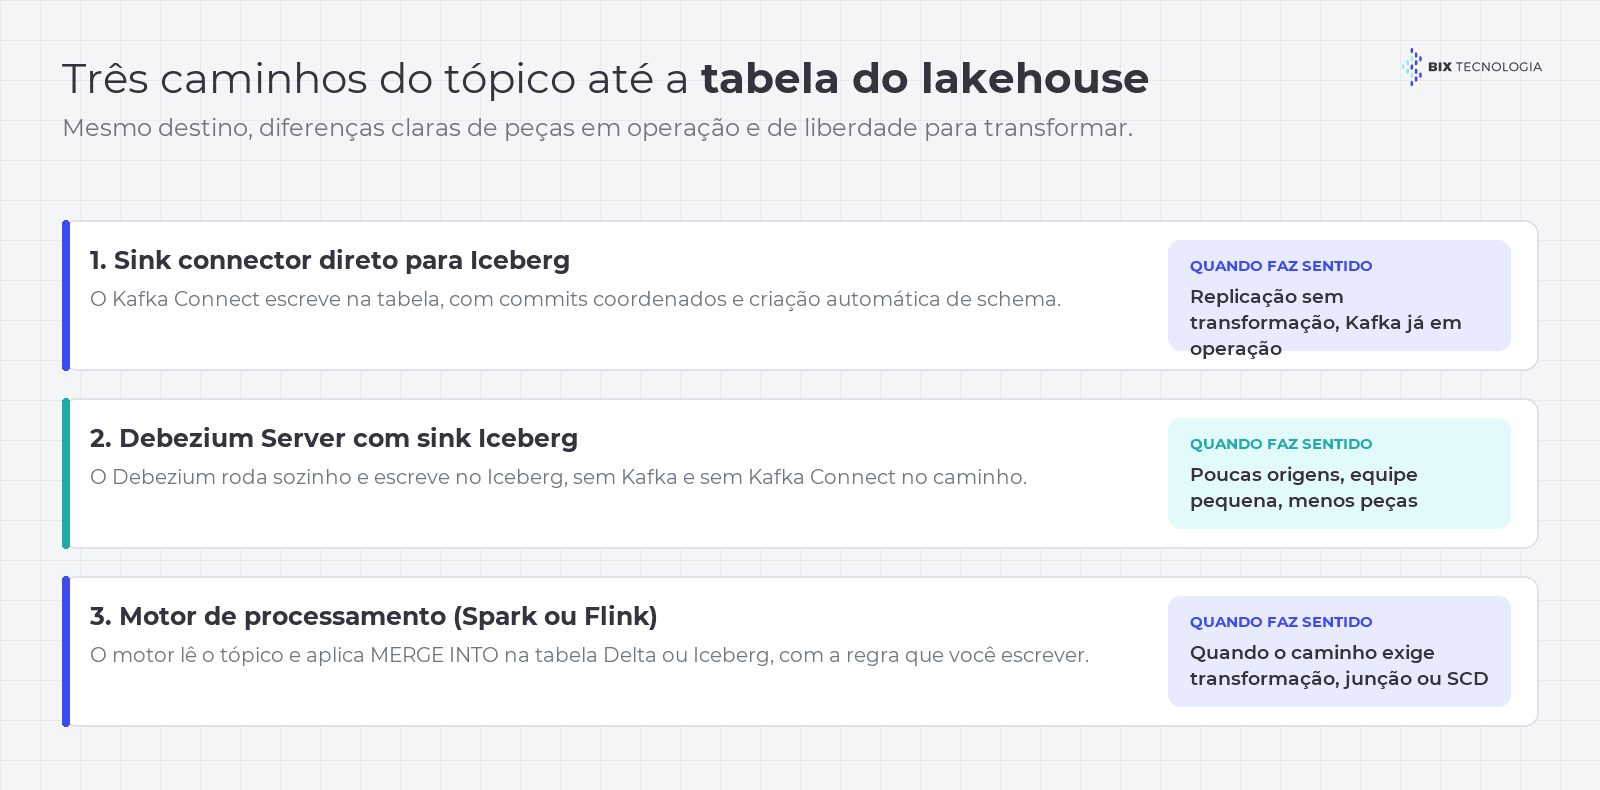
Três arranjos para o mesmo destino, com diferenças claras de peças em operação e de liberdade para transformar o dado no caminho.
O custo operacional do CDC e quando ele não compensa
Um pipeline de CDC com Kafka soma peças: o cluster Kafka, o cluster Kafka Connect, o registro de esquemas, o sink e o monitoramento de tudo isso. O time passa a acompanhar o atraso do slot, o estado de cada tarefa do conector e a fila do sink, além de negociar com a área de banco as permissões de replicação e as mudanças de parâmetro, que em serviços gerenciados costumam exigir reinício da instância. Plataformas gerenciadas de ingestão trocam esse custo por licenciamento, e a BIX trabalha com várias combinações de nuvem, formato de tabela e ferramenta de ingestão: a decisão certa depende do inventário de origens, da latência que o negócio usa de fato e de quem vai operar o pipeline no dia seguinte.
Existem casos em que a carga incremental segue adequada. Tabelas de domínio pequenas, que mudam pouco e alimentam relatório diário, não justificam a infraestrutura, e tabelas append-only de eventos imutáveis dispensam CDC, porque a própria coluna de data resolve o recorte. A pergunta que separa os dois mundos é direta: se um DELETE ou um estado intermediário passar despercebido, alguém decide errado? Quando a resposta é sim, o log de transações deixa de ser opcional. Essa avaliação anda junto com a decisão entre processamento em lote e em streaming, que define a latência de toda a esteira.
O change data capture resolve um problema específico: levar o estado de um banco transacional para o lakehouse sem perder deletes e sem pesar sobre a carga operacional. O Debezium entrega a leitura com maturidade e documentação, e o desafio real fica na aplicação dos eventos no destino, onde ordenação, deduplicação e tratamento de delete decidem se a tabela analítica bate com a origem. Comece por uma origem só, com duas ou três tabelas de negócio, meça o atraso ponta a ponta por uma semana e só depois amplie o inventário. É o princípio de qualquer projeto sério de ingestão de dados: provar a esteira em escala pequena antes de levar o time inteiro para dentro dela.
Se a sua empresa está avaliando substituir cargas incrementais por change data capture, ou já tem Debezium rodando e quer resolver a aplicação dos eventos no lakehouse, nossos especialistas podem ajudar a estruturar a melhor arquitetura para o seu contexto. Fale com a nossa equipe e avance na maturidade dos seus dados.

Perguntas frequentes sobre change data capture
O que é change data capture? Change data capture é a técnica que captura inserções, atualizações e exclusões de um banco de dados lendo o log de transações que ele já escreve, como o WAL do PostgreSQL ou o binlog do MySQL. Cada mudança vira um evento com imagem anterior, imagem nova e metadados de origem, disponível segundos após o commit.
Como o Debezium captura mudanças do PostgreSQL? O conector do Debezium se conecta ao PostgreSQL como consumidor de replicação lógica. A configuração exige wal_level=logical, um slot de replicação que registra a posição já lida, no formato de LSN, e uma publication que define as tabelas capturadas. O conector faz um snapshot inicial e depois transmite cada mudança do WAL.
Qual a diferença entre CDC por log e carga incremental por coluna de data? O CDC por log lê o log de transações e enxerga deletes, estados intermediários e a ordem de commit, sem consultar as tabelas. A carga incremental consulta periodicamente as linhas com data de atualização recente, perde deletes, perde estados intermediários e depende de uma coluna de data preenchida de forma confiável.
Como aplicar eventos de CDC em uma tabela Iceberg ou Delta? Achate o evento com a transformação ExtractNewRecordState, deduplique por chave primária mantendo o mais recente segundo o LSN e aplique um MERGE na tabela de destino. As opções vão do sink connector do Iceberg ao Spark Structured Streaming com MERGE INTO, passando pelas APIs AUTO CDC do Databricks.
É possível usar Debezium sem Kafka? Sim. O Debezium Server roda o conector como aplicação autônoma e envia os eventos para destinos como Kinesis, Pub/Sub, Pulsar, Redis Streams, JDBC e Apache Iceberg, sem Kafka Connect no caminho. O sink de Iceberg, mantido pela comunidade, suporta modo upsert com deduplicação e marcação de deletes.